Robots.txt 2026: Optimización Avanzada para SEO y Control de Rastreo
En el dinámico mundo del SEO, cada detalle cuenta. Desde la calidad del contenido hasta la velocidad de carga, cada factor influye en cómo los motores de búsqueda perciben y clasifican tu sitio web. Sin embargo, hay un pequeño archivo de texto, a menudo subestimado, que juega un papel crucial en esta ecuación: el robots.txt. En 2026, su importancia no solo se mantiene, sino que se intensifica, convirtiéndose en una herramienta indispensable para cualquier estrategia digital de robots.txt optimización SEO.
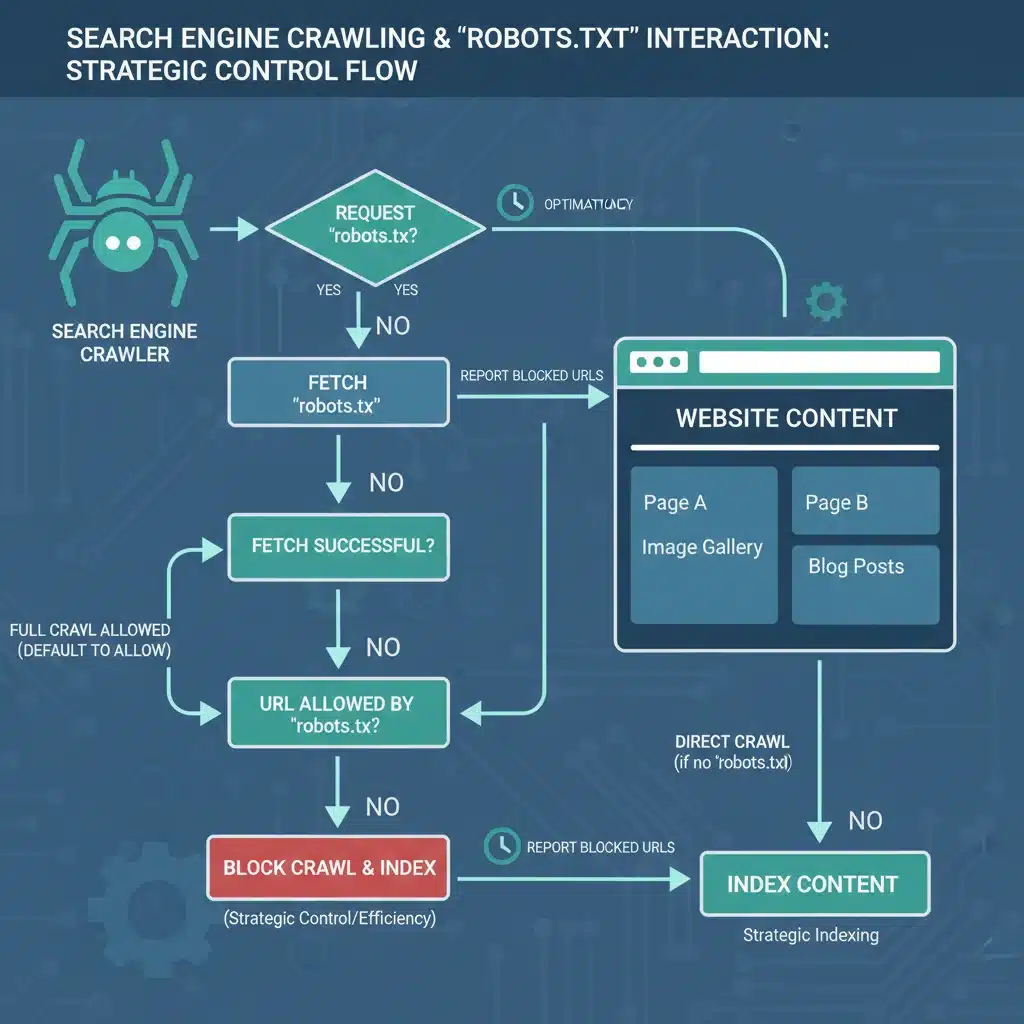
El archivo robots.txt es la primera línea de comunicación entre tu sitio web y los rastreadores de los motores de búsqueda. Actúa como un portero digital, indicando a los bots qué áreas de tu sitio pueden visitar y cuáles deben evitar. Una configuración incorrecta puede tener consecuencias desastrosas, desde la no indexación de contenido vital hasta la sobrecarga de tu servidor por un rastreo ineficiente. Por otro lado, una optimización adecuada puede catapultar tu rendimiento SEO, mejorar la eficiencia del rastreo y, en última instancia, aumentar tu visibilidad online.
Este artículo te guiará a través de los entresijos del robots.txt optimización SEO en el contexto de 2026. Exploraremos las mejores prácticas, las nuevas consideraciones y cómo puedes utilizar este potente archivo para maximizar el potencial de tu sitio web. Prepárate para desentrañar los secretos de un rastreo eficiente y una indexación superior.
¿Qué es el archivo Robots.txt y por qué es Crucial en 2026?
El archivo robots.txt es un simple archivo de texto que reside en el directorio raíz de tu sitio web (por ejemplo, tudominio.com/robots.txt). Su propósito principal es dar instrucciones a los rastreadores web (también conocidos como arañas o bots) sobre qué partes de tu sitio pueden o no rastrear. Es parte del Protocolo de Exclusión de Robots, un estándar para que los sitios web se comuniquen con los rastreadores web.
La Evolución del Rastreo Web y Robots.txt
A lo largo de los años, la forma en que los motores de búsqueda rastrean e indexan la web ha evolucionado drásticamente. En 2026, los bots son más sofisticados, el contenido es más dinámico y la competencia por la visibilidad es feroz. Esto significa que la gestión del rastreo, facilitada por el robots.txt, es más crítica que nunca. No se trata solo de bloquear contenido, sino de guiar a los bots de manera estratégica para que concentren sus recursos en las páginas más importantes y de mayor calidad.
Importancia para la robots.txt optimización SEO
- Control del Presupuesto de Rastreo: Cada sitio web tiene un “presupuesto de rastreo” asignado por los motores de búsqueda. Este presupuesto determina cuántas páginas puede rastrear un bot en un período de tiempo determinado. Al usar el robots.txt para bloquear páginas de bajo valor o duplicadas, aseguras que los bots gasten su presupuesto en tu contenido más relevante, lo que es fundamental para una buena robots.txt optimización SEO.
- Evitar la Indexación de Contenido Sensible o Duplicado: Puedes usar el robots.txt para evitar que los motores de búsqueda indexen áreas de tu sitio que no son relevantes para el público (como páginas de administración, carritos de compra vacíos, resultados de búsqueda internos) o contenido duplicado que podría diluir el valor SEO de tus páginas principales.
- Mejora de la Experiencia del Usuario: Al evitar que los bots rastreen recursos innecesarios, puedes reducir la carga del servidor, lo que indirectamente mejora la velocidad del sitio y la experiencia del usuario, un factor SEO cada vez más importante.
- Gestión de Archivos Multimedia y de Recursos: En 2026, con la creciente complejidad de los sitios web (JavaScript, CSS, imágenes de alta resolución), el robots.txt puede ser clave para gestionar cómo los bots acceden a estos recursos, asegurando que puedan renderizar y entender tu página correctamente.
Estructura Básica y Directivas Clave del Robots.txt
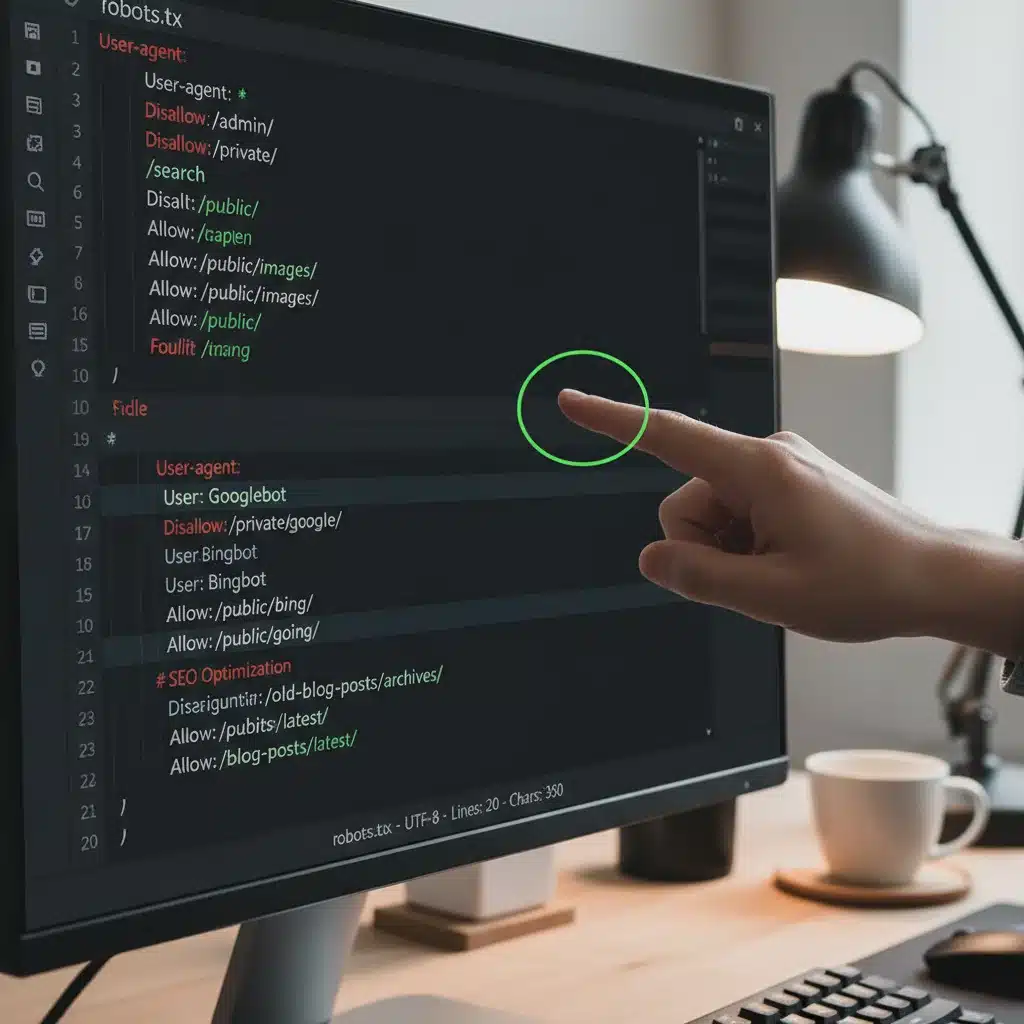
Un archivo robots.txt se compone de una o más “reglas”. Cada regla comienza con una línea User-agent, que especifica a qué rastreador se aplica la regla, seguida de una o más directivas Disallow o Allow.
Directivas Fundamentales:
User-agent:Identifica al rastreador al que se aplican las reglas. Puedes especificarUser-agent: *para aplicar las reglas a todos los rastreadores, o un rastreador específico comoUser-agent: Googlebot,User-agent: Bingbot, etc.Disallow:Indica a un rastreador que no debe acceder a un directorio o archivo específico. Por ejemplo,Disallow: /admin/bloquearía el acceso a la carpeta/admin/y todo su contenido.Allow:Esta directiva se utiliza a menudo junto conDisallowpara permitir el acceso a subdirectorios o archivos específicos dentro de un directorio que de otro modo estaría bloqueado. Por ejemplo,Disallow: /wp-content/yAllow: /wp-content/uploads/.Sitemap:Aunque no es una directiva de bloqueo, es una práctica recomendada incluir la URL completa de tus sitemaps XML al final de tu archivo robots.txt. Esto ayuda a los motores de búsqueda a descubrir todas las páginas importantes de tu sitio.
Ejemplo Básico de Robots.txt:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /wp-includes/
Disallow: /wp-json/
Disallow: /search?
Sitemap: https://www.tudominio.com/sitemap.xml
Este ejemplo bloquea las carpetas de administración y los archivos de inclusión de WordPress, las rutas JSON y las páginas de resultados de búsqueda interna, mientras permite un archivo específico en wp-admin que podría ser necesario para el funcionamiento del sitio. También señala la ubicación del sitemap.
Estrategias Avanzadas de Robots.txt Optimización SEO en 2026
Más allá de lo básico, la verdadera robots.txt optimización SEO implica una comprensión profunda de cómo los rastreadores interactúan con tu sitio y cómo puedes influir en ese proceso para tu beneficio.
1. Gestión del Presupuesto de Rastreo (Crawl Budget)
El presupuesto de rastreo es finito. Para sitios grandes, con miles o millones de páginas, una gestión eficiente es vital. Identifica y bloquea:
- Parámetros de URL: Filtros, ordenaciones, IDs de sesión que crean URLs duplicadas (
Disallow: /*?*o patrones más específicos). - Páginas de Paginación Innecesarias: A veces, las páginas de paginación que no ofrecen valor SEO directo pueden ser bloqueadas si ya estás gestionando el contenido principal de otra manera.
- Contenido Duplicado o de Bajo Valor: Páginas de etiquetas, categorías vacías, archivos de autor sin contenido significativo, versiones de prueba o staging del sitio.
- Archivos de Recursos No Críticos: Scripts o estilos no esenciales que los bots no necesitan procesar para entender el contenido principal.
2. Diferenciación por User-agent
Algunos rastreadores tienen diferentes propósitos. Puedes personalizar las reglas para ellos. Por ejemplo:
User-agent: Googlebot
Disallow: /private-google/

User-agent: Bingbot
Disallow: /private-bing/
Esto es útil si tienes contenido específico que quieres ocultar de un motor de búsqueda pero no de otro, aunque es una práctica menos común y debe usarse con precaución.
3. Uso de Expresiones Regulares (Wildcards)
Los archivos robots.txt modernos permiten el uso de wildcards (comodines) para hacer las reglas más flexibles y potentes. Los dos comodines principales son:
*(asterisco): Coincide con cualquier secuencia de caracteres.$(signo de dólar): Coincide con el final de una URL.
Ejemplos:
Disallow: /category/*/page/: Bloquea todas las páginas bajo cualquier subdirectorio de/category/.Disallow: /*.pdf$: Bloquea todos los archivos PDF.Allow: /wp-content/uploads/*.jpg$: Permite solo archivos JPG dentro de uploads.
4. Consideraciones para Sitios con JavaScript y SPA (Single Page Applications)
En 2026, la mayoría de los sitios web utilizan JavaScript de forma intensiva. Googlebot (y otros rastreadores avanzados) pueden renderizar JavaScript. Sin embargo, si bloqueas archivos CSS o JavaScript esenciales a través de robots.txt, los bots podrían tener dificultades para renderizar y entender el contenido y el diseño de tu página. Esto puede afectar negativamente tu SEO.
- Nunca bloquees CSS y JS esenciales: Asegúrate de que los archivos CSS y JavaScript que son críticos para la renderización de tu página estén permitidos para el rastreo.
- Prueba con Google Search Console: Utiliza la herramienta de inspección de URL de Google Search Console para ver cómo Googlebot renderiza tus páginas y asegúrate de que no haya recursos bloqueados que impidan una correcta visualización.
5. Monitoreo y Análisis del Rastreo
La robots.txt optimización SEO no es un proceso de “configurar y olvidar”. Debes monitorear regularmente cómo los bots están rastreando tu sitio.
- Informes de Rastreo de Google Search Console: Esta herramienta es invaluable. Te muestra qué páginas se han rastreado, qué errores se han encontrado y cómo está siendo utilizado tu presupuesto de rastreo.
- Archivos de Registro del Servidor (Server Logs): Analizar los logs de tu servidor te dará una visión directa de qué bots están visitando tu sitio, qué páginas están solicitando y con qué frecuencia.
Errores Comunes a Evitar en la Optimización de Robots.txt
Un pequeño error en tu archivo robots.txt puede tener grandes repercusiones. Aquí están algunos de los errores más comunes:
1. Bloquear Contenido Crítico por Accidente
El error más grave. Bloquear por error todo el sitio (Disallow: /) o secciones importantes impedirá que los motores de búsqueda rastreen e indexen tus páginas, lo que resultará en una pérdida total de visibilidad SEO. Siempre verifica tus cambios.
2. Confundir Disallow con Noindex
Es crucial entender que Disallow en robots.txt le dice a los bots que *no rastreen* una página. No les dice que *no la indexen*. Si una página bloqueada por robots.txt recibe enlaces externos, Google podría aún indexar la URL (aunque sin contenido) mostrando un mensaje como “Una descripción de resultados para este sitio no está disponible debido al archivo robots.txt de este sitio”. Para evitar la indexación, debes usar la metaetiqueta noindex o la cabecera X-Robots-Tag en la propia página.
3. Bloquear CSS y JavaScript Esenciales
Como se mencionó, esto puede impedir que los motores de búsqueda rendericen tu página correctamente, afectando su capacidad para entender el contenido y su diseño responsivo, lo que puede perjudicar tu clasificación.
4. Sintaxis Incorrecta
Un simple error tipográfico o una sintaxis incorrecta pueden invalidar tus reglas. Siempre usa un validador de robots.txt (como el que se encuentra en Google Search Console) para verificar tu archivo.
5. Falta de un Robots.txt
Aunque no es un error en sí mismo (los bots asumirán que pueden rastrear todo), no tener un robots.txt significa que pierdes la oportunidad de optimizar el rastreo y el presupuesto de rastreo de tu sitio. Es una oportunidad perdida para la robots.txt optimización SEO.
Herramientas para la Gestión y Validación de Robots.txt
Afortunadamente, no estás solo en el proceso de robots.txt optimización SEO. Varias herramientas pueden ayudarte a validar y gestionar tu archivo.
1. Google Search Console (GSC)
El “Probador de robots.txt” en GSC es una herramienta indispensable. Te permite:
- Ver tu archivo robots.txt actual.
- Probar nuevas reglas antes de implementarlas.
- Identificar errores de sintaxis.
- Ver qué URLs de tu sitio están bloqueadas por el robots.txt.
Además, los informes de cobertura de indexación y de estadísticas de rastreo en GSC te darán información valiosa sobre cómo Googlebot está interactuando con tu sitio después de aplicar tus reglas de robots.txt.
2. Analizadores de Archivos de Registro (Log File Analyzers)
Herramientas como Screaming Frog SEO Spider (que tiene una función de análisis de archivos de registro) o Logz.io te permiten ver qué rastreadores están accediendo a tu sitio, qué páginas están rastreando y con qué frecuencia. Esto es crucial para entender el impacto real de tus directivas de robots.txt optimización SEO y para identificar posibles problemas de presupuesto de rastreo.
3. Auditores SEO (Ahrefs, Semrush, Sitebulb)
La mayoría de las herramientas de auditoría SEO populares incluyen verificaciones de robots.txt como parte de sus rastreos. Pueden señalar problemas como páginas importantes bloqueadas, sitemaps no declarados o errores de sintaxis.
Robots.txt y la Sinergia con otras Directivas SEO
El robots.txt no funciona de forma aislada. Su eficacia se multiplica cuando se combina estratégicamente con otras directivas SEO.
Relación con la Meta Etiqueta Noindex
Como se mencionó, Disallow evita el rastreo, mientras que noindex evita la indexación. Si tienes páginas que quieres que Google no muestre en los resultados de búsqueda, pero que aún quieres que los bots rastreen (por ejemplo, para seguir enlaces internos), usa noindex. Si no quieres que los bots pierdan tiempo rastreando esas páginas, entonces Disallow en robots.txt es apropiado, pero ten en cuenta que el noindex no será descubierto si la página está bloqueada por robots.txt.
Relación con Canonicalización
Para abordar el contenido duplicado, la etiqueta canónica (<link rel="canonical" href="...">) es la herramienta principal. El robots.txt puede complementar esto bloqueando versiones de bajo valor de páginas duplicadas, pero la canonicalización es la que indica la versión preferida para la indexación.
Sitemaps XML
El sitemap XML es una hoja de ruta para los rastreadores, indicando todas las URLs que consideras importantes. Incluir la ruta a tu sitemap en el robots.txt (Sitemap: https://www.tudominio.com/sitemap.xml) es una práctica recomendada que asegura que los motores de búsqueda lo encuentren fácilmente y entiendan la estructura de tu sitio.
Casos de Uso Avanzados y Nuevas Tendencias en 2026
A medida que la web evoluciona, también lo hacen las aplicaciones del robots.txt.
Sitios Multilingües y Regionales
Para sitios con múltiples versiones de idioma o región, el robots.txt puede ayudar a guiar a los bots a las versiones correctas, aunque el atributo hreflang es la herramienta principal para esto. Podrías, por ejemplo, bloquear versiones de prueba de idiomas aún no lanzados.
Contenido Generado por el Usuario (UGC)
Los foros, comentarios y otras formas de UGC pueden generar una gran cantidad de URLs de bajo valor o spam. El robots.txt puede ser útil para bloquear directorios que albergan este tipo de contenido, especialmente si no se modera adecuadamente.
API y Webhooks
Con la creciente interconectividad de las aplicaciones web, es posible que tengas endpoints de API o webhooks que no deben ser rastreados. El robots.txt es el lugar ideal para bloquearlos.
Consideraciones de Privacidad y Seguridad
Aunque el robots.txt no es una medida de seguridad (cualquiera puede ver su contenido), puede ser parte de una estrategia para evitar que información sensible, como directorios de bases de datos o configuraciones internas, aparezca accidentalmente en los resultados de búsqueda.
Cómo Implementar y Actualizar tu Robots.txt
La implementación de un robots.txt es relativamente sencilla, pero la actualización requiere cuidado.
Paso a Paso para la Creación/Actualización:
- Audita tu Sitio: Identifica qué páginas y directorios son importantes para el SEO y cuáles no. Utiliza herramientas de auditoría SEO para detectar problemas de rastreo o indexación.
- Define tus Objetivos: ¿Qué quieres lograr con tu robots.txt? ¿Bloquear contenido duplicado? ¿Dirigir el presupuesto de rastreo?
- Crea o Edita el Archivo: Usa un editor de texto plano (como Notepad, Sublime Text, VS Code) para crear o modificar el archivo
robots.txt. Asegúrate de que no tenga formato HTML o caracteres especiales. - Sintaxis Correcta: Escribe tus directivas cuidadosamente, prestando atención a la sintaxis y el uso de comodines.
- Validación: Sube el archivo a Google Search Console y usa su herramienta de prueba de robots.txt para verificar que no haya errores y que las reglas funcionen como esperas.
- Sube a la Raíz del Dominio: El archivo debe estar accesible en
https://www.tudominio.com/robots.txt. - Monitorea: Después de la implementación, monitorea los informes de rastreo en GSC y los logs del servidor para asegurarte de que los cambios estén teniendo el efecto deseado.
Frecuencia de Actualización
El robots.txt no necesita actualizarse constantemente, pero sí cuando:
- Añades nuevas secciones importantes a tu sitio.
- Eliminas secciones o cambias su estructura.
- Detectas problemas de rastreo o indexación en Google Search Console.
- Implementas nuevas funcionalidades que pueden generar URLs no deseables.
Conclusión: El Robots.txt como Pilar de tu Estrategia SEO 2026
En 2026, la robots.txt optimización SEO es mucho más que una tarea técnica; es un pilar fundamental para una estrategia empresarial de SEO exitosa. Un archivo robots.txt bien configurado y mantenido te permite controlar el flujo de los rastreadores, conservar el presupuesto de rastreo, evitar la indexación de contenido no deseado y, en última instancia, dirigir a los motores de búsqueda hacia las joyas de tu sitio web.
No subestimes el poder de este pequeño archivo. Dedica tiempo a comprenderlo, optimizarlo y monitorearlo. Al hacerlo, no solo mejorarás la eficiencia del rastreo de tu sitio, sino que también sentarás las bases para una mejor visibilidad, un mayor tráfico orgánico y un posicionamiento superior en los resultados de búsqueda. La era digital de 2026 exige una precisión impecable, y tu robots.txt es tu primera herramienta para lograrla.